
5
0
详细信息
药品销售数据的颗粒度正在分化:从“大盘叙事”到“区县动销”的分析框架迁移
一个越来越明显的信号是:药品市场的总量数据正在失去方向感。
2025年全终端药品市场规模约2万亿元,同比下降1.4%,医院端占比从2021年的76.6%回落至69.4%,实体药店占比升至25.5%,网上药店以965亿元的规模成为增速最快的渠道。总量的“平”与结构的“动”同时发生,意味着用大盘增速做品种规划、用省级数据做资源分配,已经很难支撑可执行的结论。当市场从普涨转入结构性调整,判断的精度只能从数据颗粒度里找。
这个判断背后有一个容易被忽略的分析断层:行业不缺数据,缺的是数据能在同一套逻辑下逐层对话。 医院、药店、线上各有一套口径,省级和区县分属不同来源,放大总量和样本细节之间缺少校验接口。结果是,很多分析停在“总量判断”层面,因为往下走的每一步都需要额外的数据对齐成本。
一、终端整合:从“多渠道覆盖”到“同一视图下的结构对照”
多终端数据本身不是新概念。医院端、零售端、线上的数据产品在市场上并不稀缺,但它们的组织方式通常是并列的——你需要分别打开三个库,分别拉取数据,再在Excel里做口径对齐。这个过程的隐性成本很高,而且极易在结构变化的关键节点上滞后。
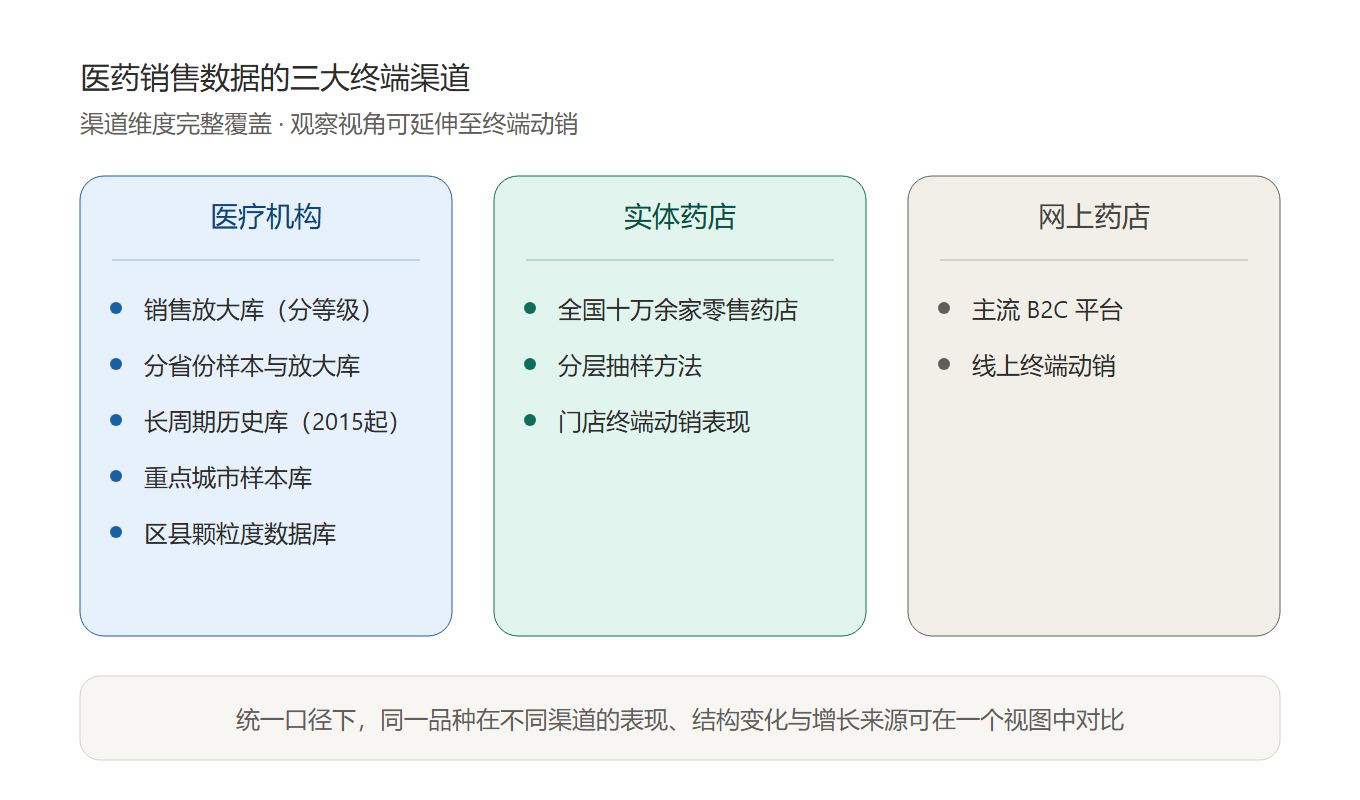
真正有分析价值的是同一品种在不同渠道之间的流转关系。2025年零售端肿瘤治疗药物及免疫调节剂、心脑血管疾病用药合计占比已超过27%,处方外流和慢病复购正在重塑零售端的品类结构。一个品种在院内承压之后,院外到底接住了多少、通过哪个终端接住的、增速是否可持续——这些问题在“分库并列”的数据组织方式下很难快速回答,但在“统一口径同视图”的框架下,就变成了一个可以直接对照的分析起点。
二、地域下钻:区县颗粒度解决的不是“看得更细”,而是“归因能不能落地”
省级数据回答的是“哪个省在涨”,但它回答不了“涨在哪个区县、哪类机构”。2025年县级公立医院销售额同比下降6.5%,乡镇卫生院下降4.9%,降幅梯度本身就说明同一省内不同层级市场的走势可以显著分化。一个品种在省级层面表现平稳,底下可能是核心城市在扛、区县在拖,也可能是相反的情况。省级大盘是平均值,而平均值在区域决策中往往是最需要被拆开的那个数。
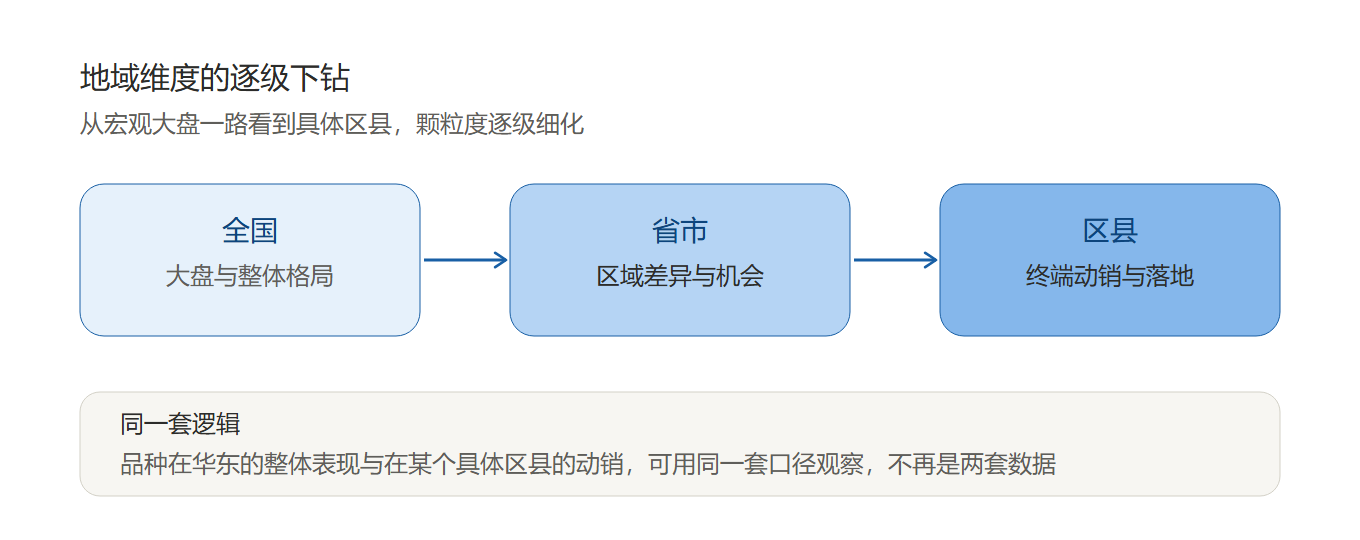
“全国—省市—区县”逐级下钻的分析意义不在于地图放大了一级,而在于归因链条可以从大盘一路追到执行层。同一个品种在华东的整体表现和在某个具体区县的动销,如果能用同一套口径观察,区域机会挖掘就不再停留在定性推测的层面。
三、多颗粒度交叉验证:数据体系的可靠性来自“口径之间能互相检验”
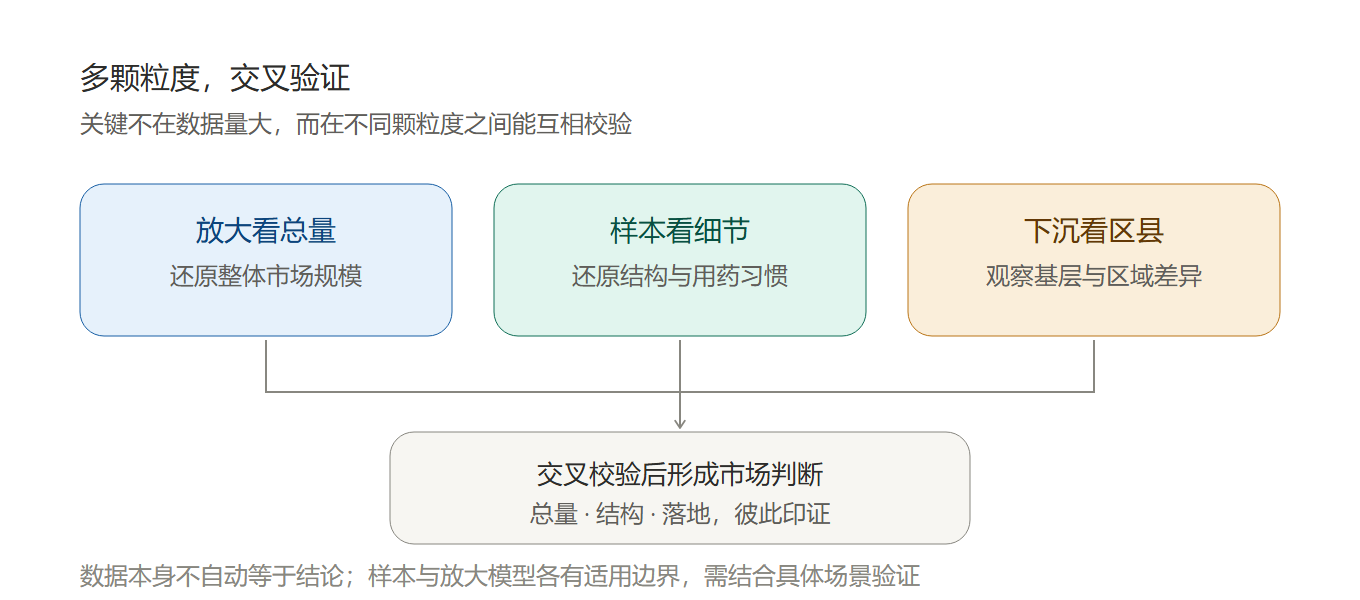
单一数据源的风险不在于“数据量不够”,而在于结论缺少第二套口径的校验。放大库擅长还原总量和市场规模,但在结构细节上天然粗糙;样本库在用药习惯和品种结构上更贴近真实世界,但外推总量时依赖模型假设;区县颗粒度数据能捕捉下沉市场的执行信号,但覆盖面有限。三者各自的盲区,恰好是另外两者的优势区间。
“放大看总量、样本看细节、下沉看区县”之所以构成一个分析体系而不是三个独立数据库,关键在于交叉验证:一个区域的机会信号,如果在放大库里表现为规模增长、在样本库里得到结构印证、在区县库里能看到终端动销的支撑,结论的可信度才足以进入业务决策环节。数据本身不自动等于结论,多颗粒度互证的价值,在于让判断可以被另一套口径“复核”。
四、摩熵5.0在这个框架里做了什么
近期摩熵医药5.0的销售数据升级,方向与上述分析框架的迁移基本对齐:地域维度打通了从全国到省市再到区县的逐级下钻;渠道维度将医疗机构、实体药店、网上药店整合进统一分析框架,同一品种跨终端的表现和结构变化可以在同一视图下对照;医疗机构端形成了放大库(分等级/城乡标签)、分省份样本库与区县颗粒度数据库的多层次配置,配合长周期历史库(2015年起),支撑“总量—细节—下沉”三个层面的交叉校验。
对药讯导航的读者而言,值得关注的不是功能列表本身,而是这类数据基础设施的迭代是否降低了从“大盘判断”走向“终端执行”的分析摩擦。当区域市场的分化速度超过年度报告和省级汇总的更新频率时,数据体系能否让判断的颗粒度跟上市场变化的颗粒度,才是真正的分水岭。
随机推荐
最新推荐